

Bagi kita yang mengelola arsitektur database skala enterprise dengan sistem replikasi lintas benua (seperti dari Data Center utama ke Disaster Recovery Center / DRC), ada satu fenomena yang pasti pernah membuat detak jantung berdebar lebih cepat: Replication Lag.
Pernahkah kita menyadari situasi di mana sebuah transaksi sudah dinyatakan sukses (COMMIT) di server Primary, tetapi ketika pengguna melakukan refresh halaman yang mengambil data dari server Standby, data tersebut belum muncul? Jeda waktu inilah yang kita sebut sebagai Replication Lag.
Mari kita bedah anatomi dari masalah ini, mengapa ia terjadi, dan bagaimana cara profesional menanganinya.
“Replication lag bukanlah sebuah bug yang harus dibasmi, melainkan hukum fisika jaringan yang harus kita kelola. Mengukur jeda milidetik antara dua data center adalah seni menyeimbangkan konsistensi data dan ketersediaan sistem”
Agus Syarif
Senior Database Engineer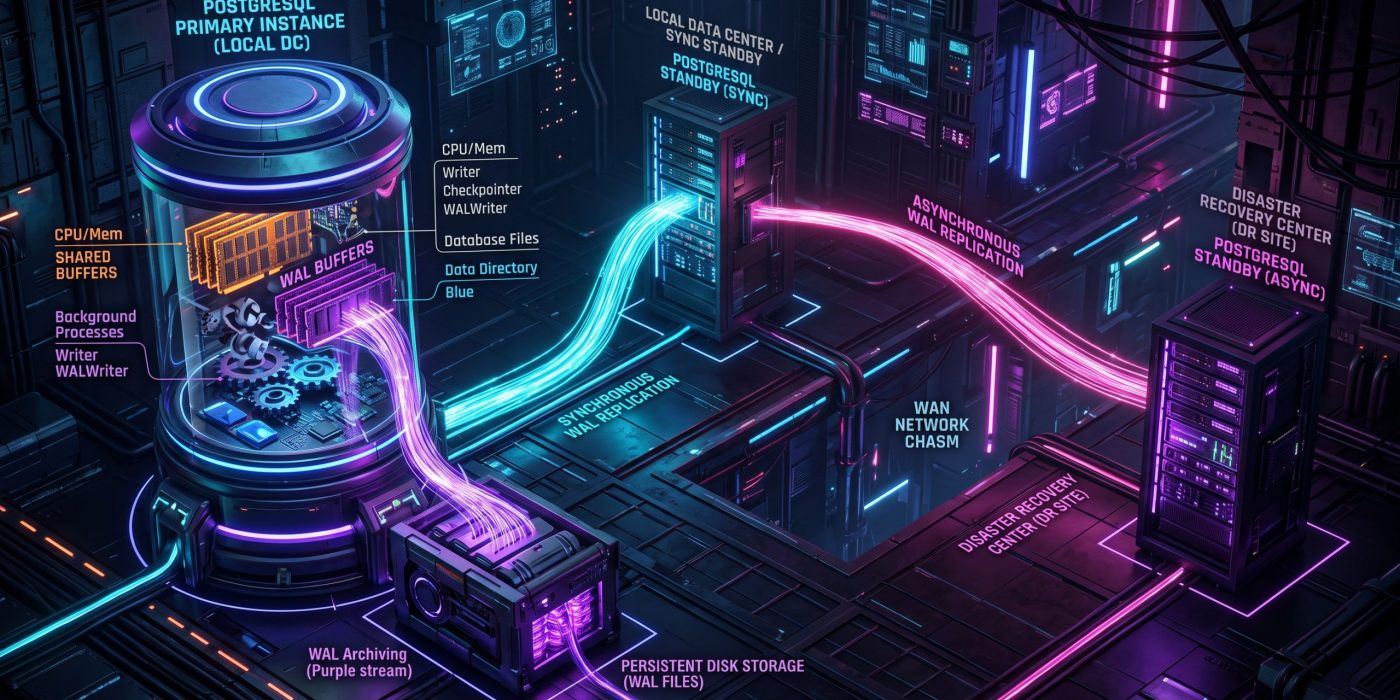
Apa Sebenarnya Replication Lag Itu?
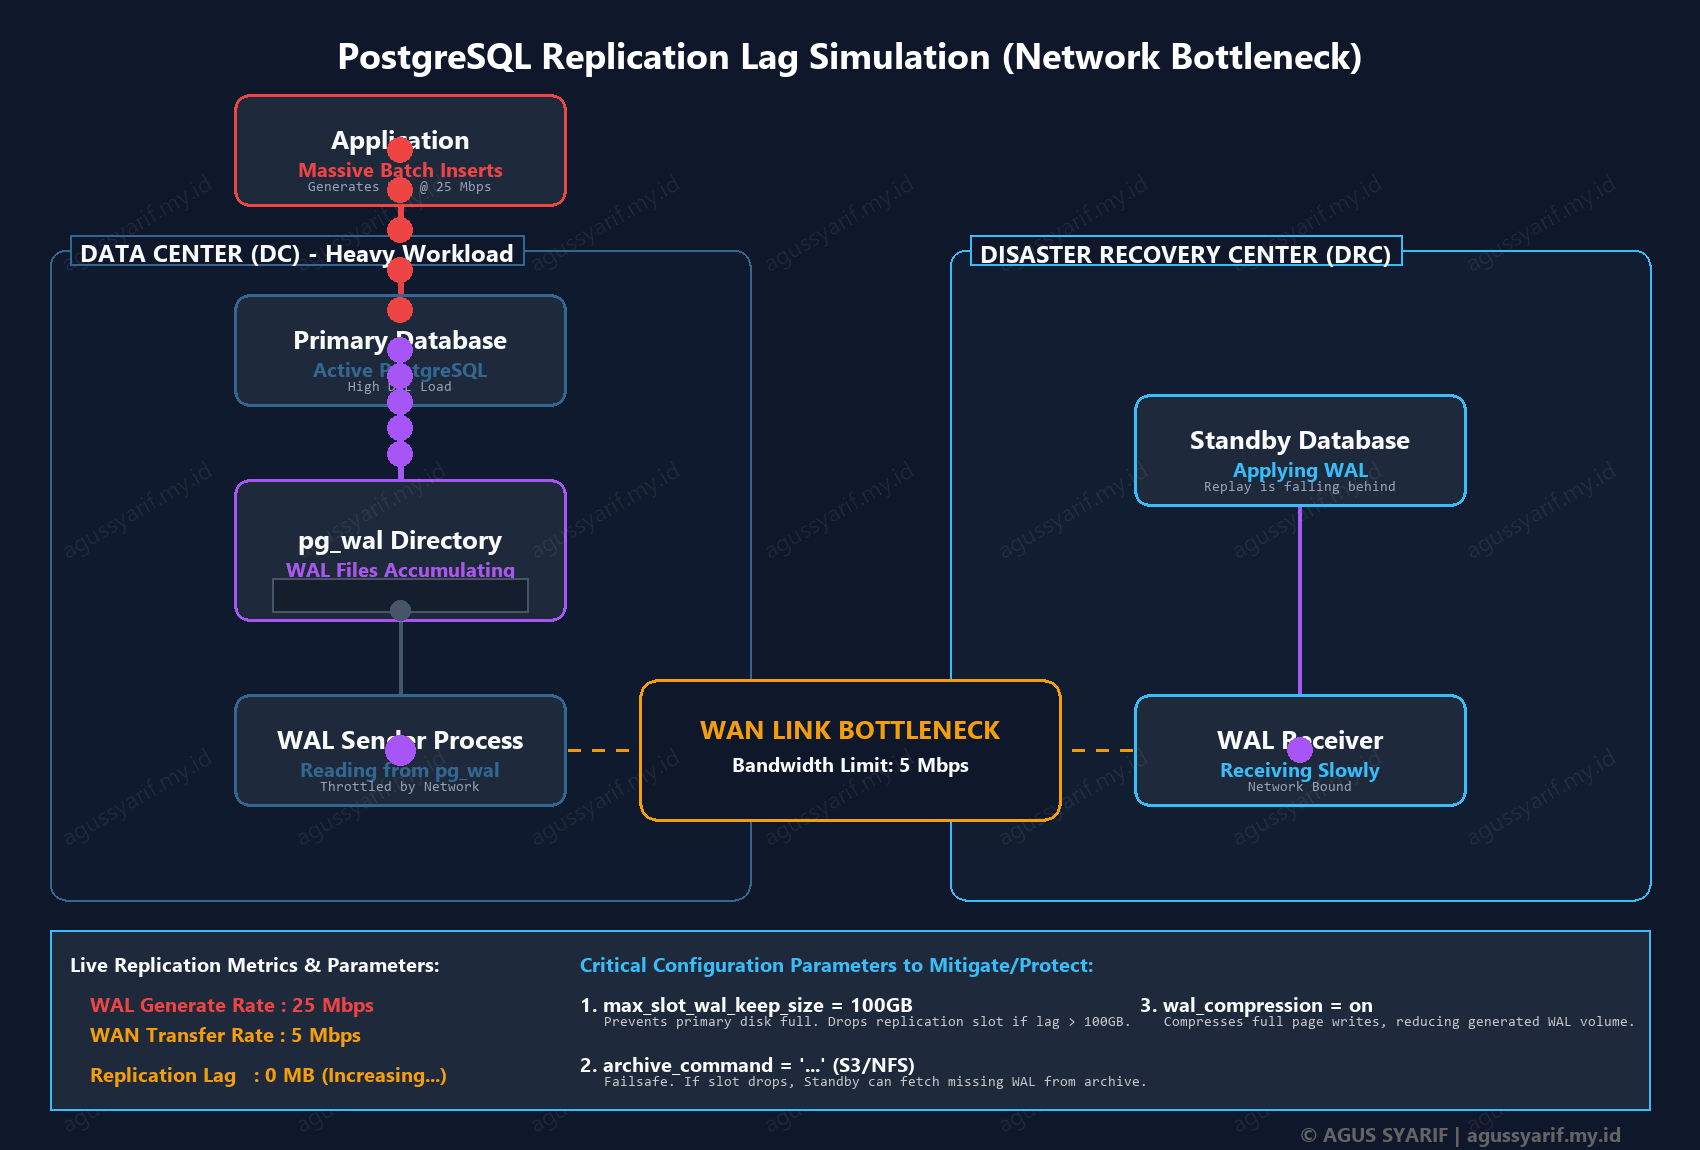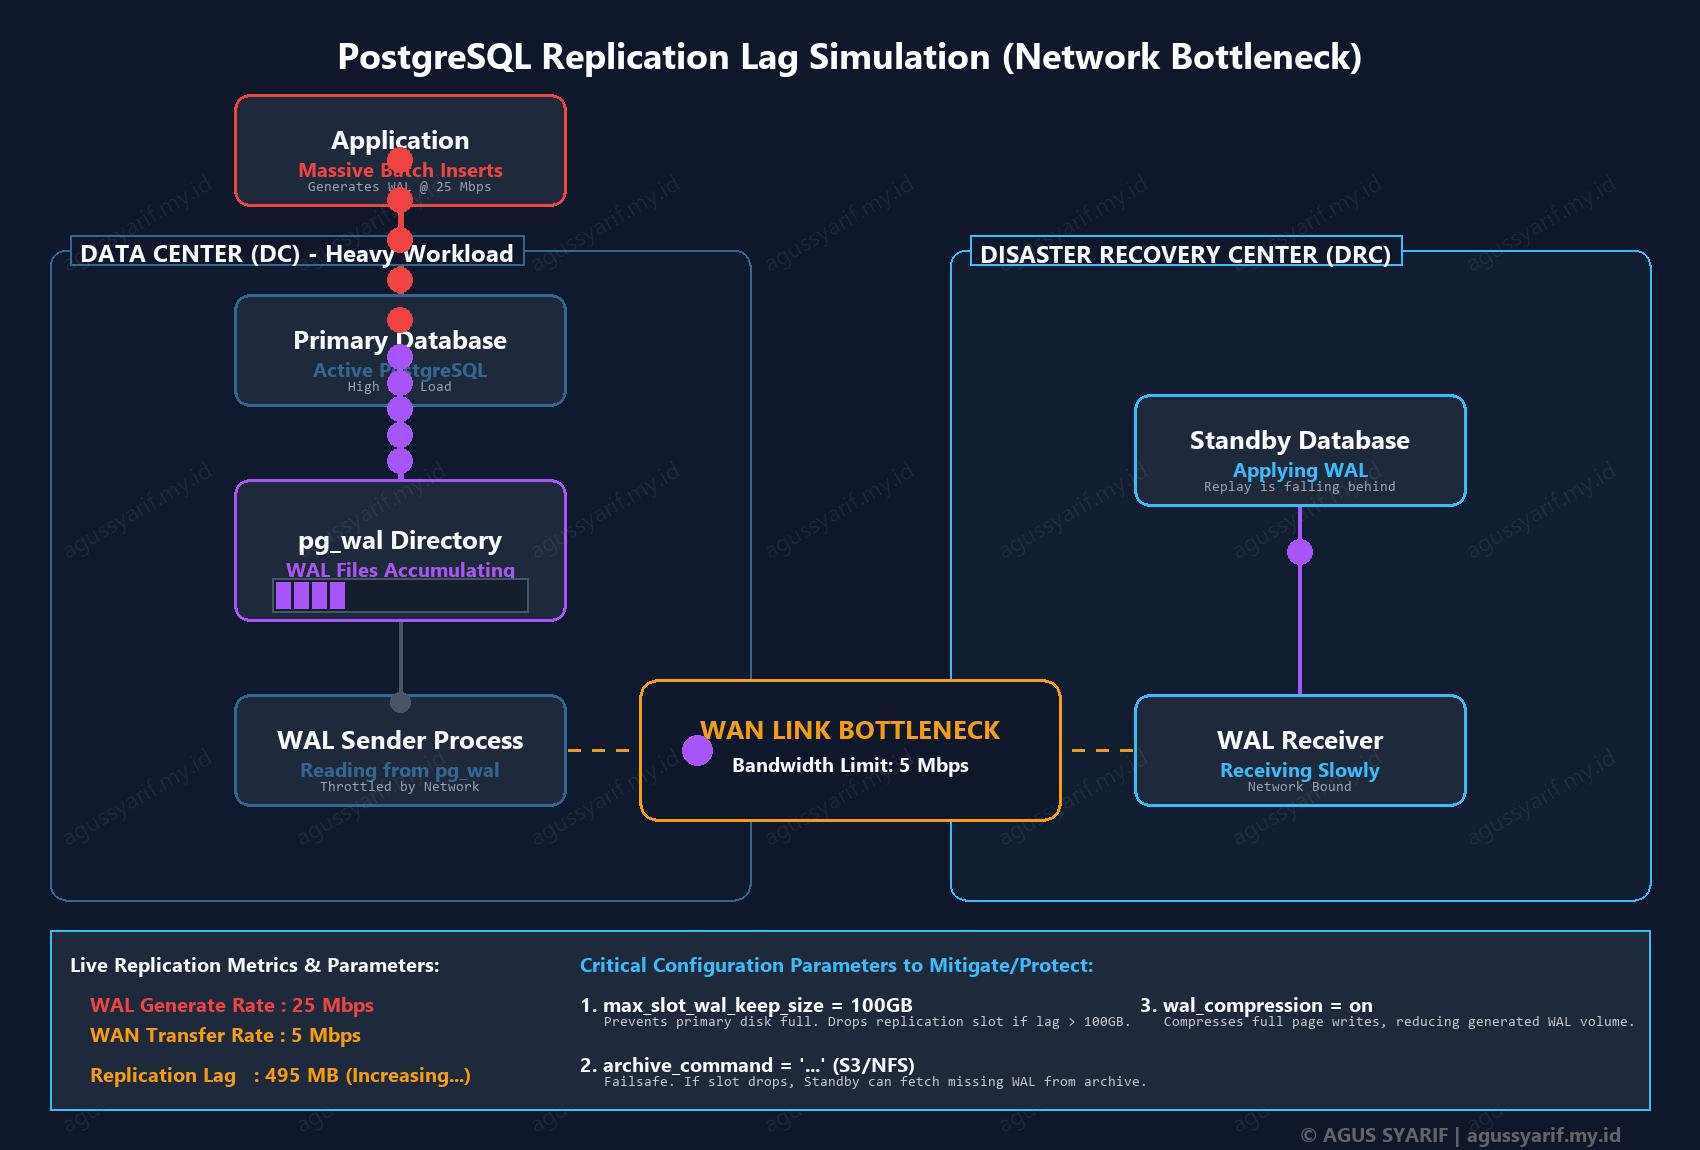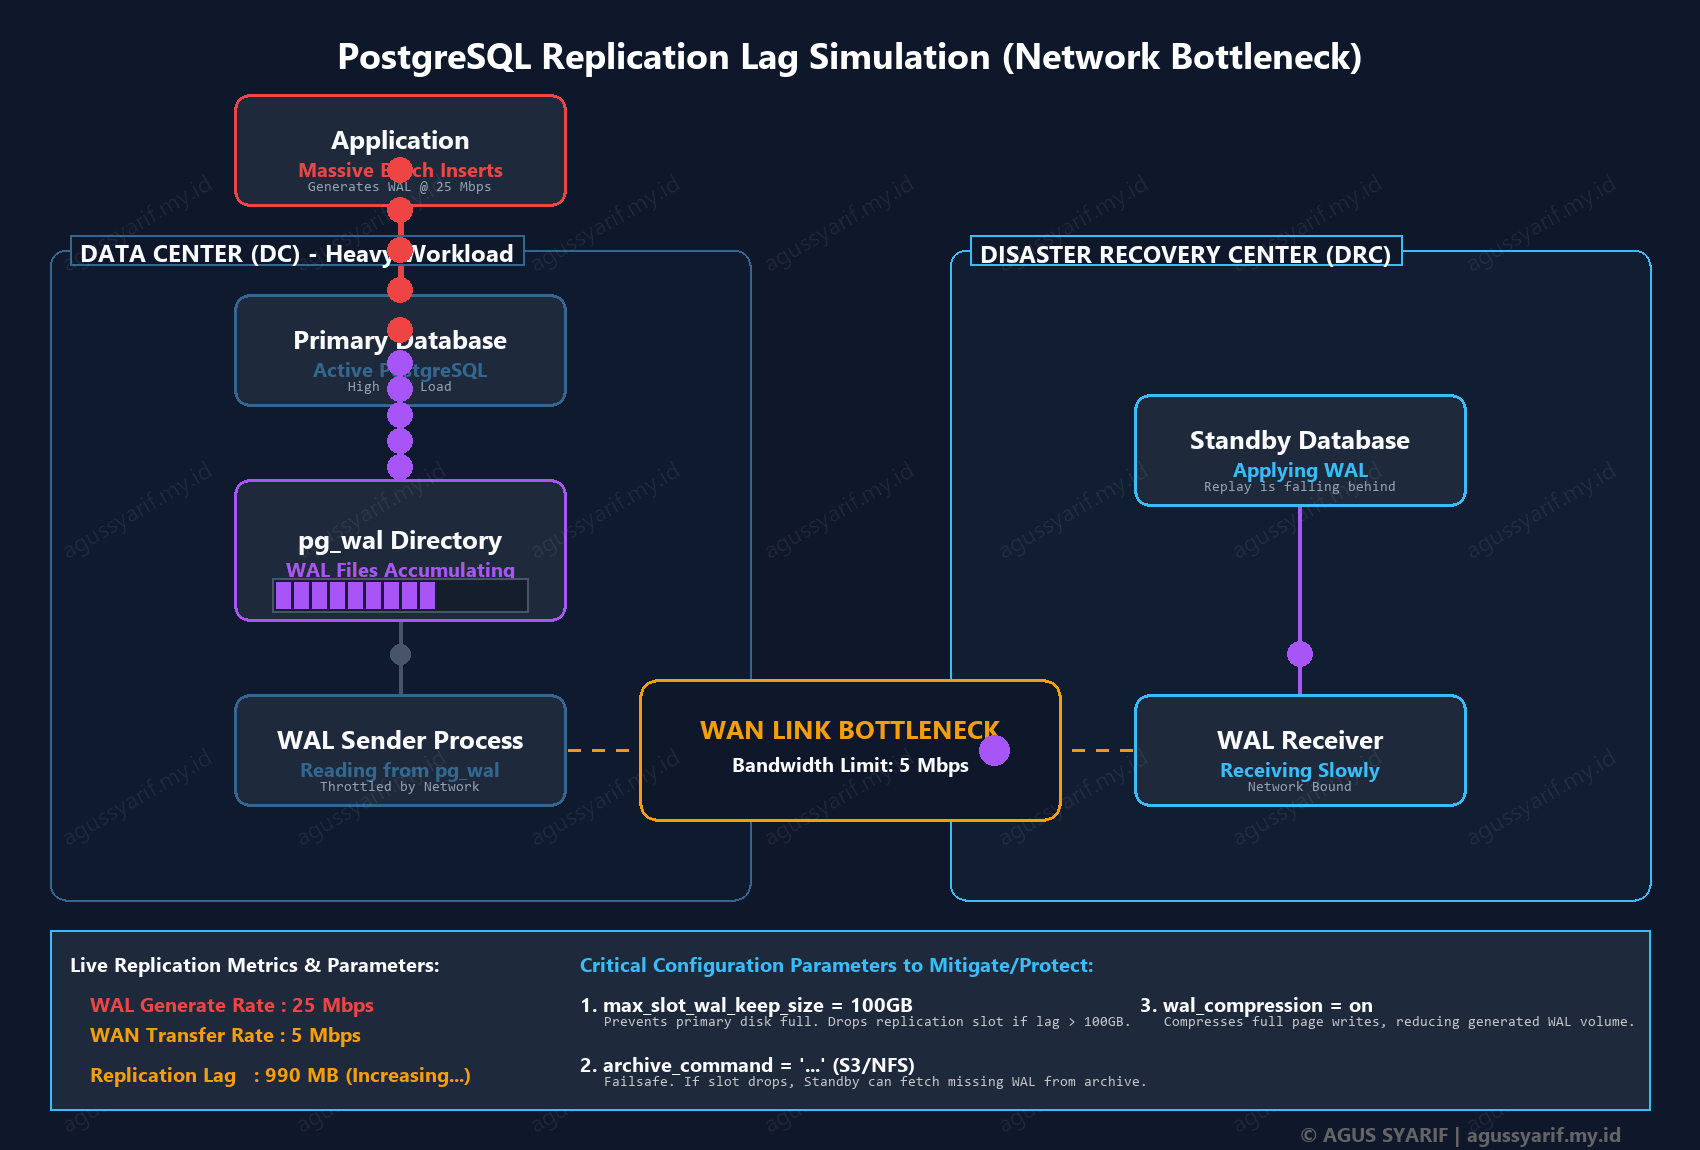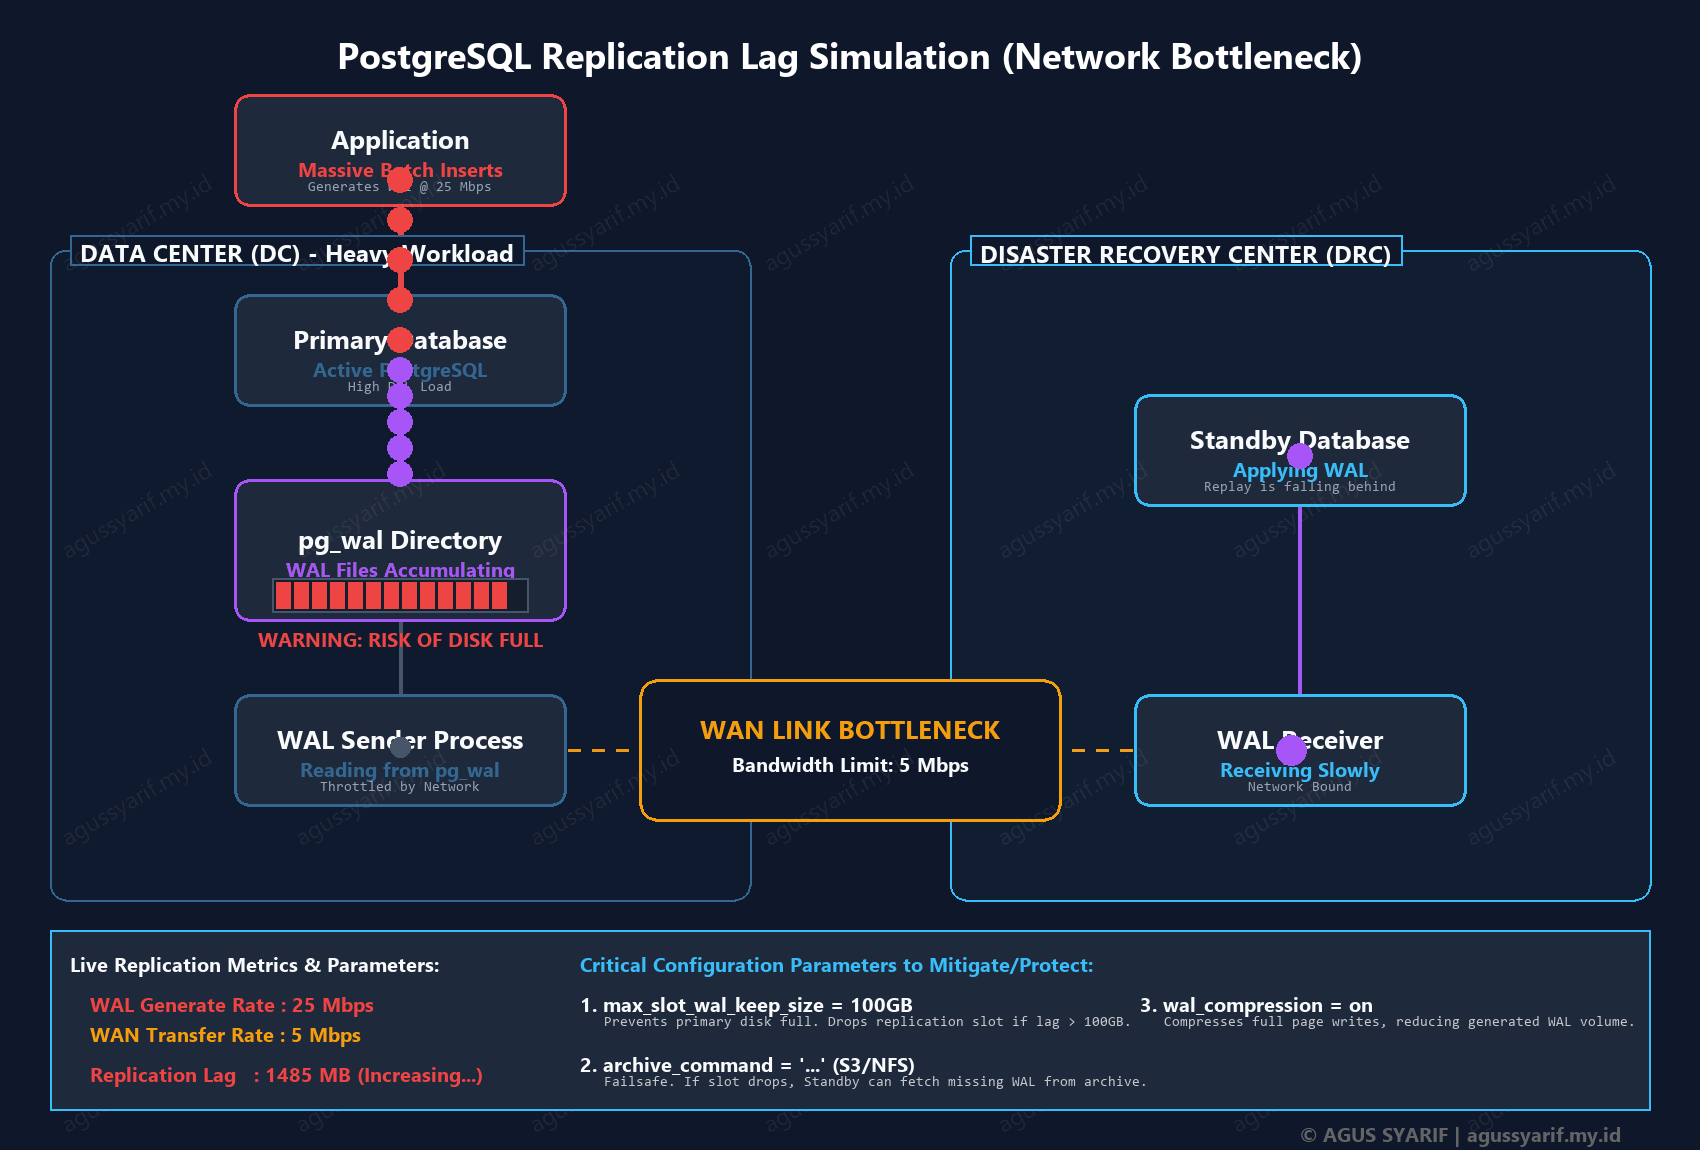
Dalam arsitektur PostgreSQL (terutama pada Asynchronous Replication yang biasa digunakan untuk DRC), aliran data terjadi melalui pengiriman Write-Ahead Logs (WAL).
Idealnya, siklus ini berjalan instan:
- Server Primary mencatat transaksi ke dalam WAL.
- Proses WAL Sender mengirimkannya melalui jaringan.
- Proses WAL Receiver di server Standby menerimanya.
- Proses Startup di Standby menerapkan (apply/replay) WAL tersebut ke dalam disk.
Replication Lag terjadi ketika kecepatan langkah ke-4 (Apply) tertinggal jauh dibandingkan kecepatan langkah ke-1 (Write di Primary). Akibatnya, paket-paket data menumpuk seperti kemacetan lalu lintas, membuat LSN (Log Sequence Number) di Standby tertinggal di belakang Primary.
3 Potensi Utama Penyebab Lag
Berdasarkan pengalaman panjang di lapangan, lag jarang sekali disebabkan oleh kelemahan bawaan PostgreSQL. Biasanya, ini adalah gejala dari arsitektur yang kewalahan. Tiga penyebab utamanya adalah:
- Latensi Jaringan (WAN Fisik) Kita tidak bisa mengalahkan hukum fisika. Mengirimkan jutaan paket data per detik melalui internet antar data center membutuhkan waktu. Jika bandwidth jaringan antar lokasi penuh atau latensinya sangat tinggi, WAL Sender di Primary tidak akan bisa mengirimkan data secepat aplikasi menuliskannya.
- Lonjakan DML Masif (Batch Jobs) Seringkali kita menjalankan proses batch UPDATE, DELETE, atau Data Migration massal di server Primary pada malam hari. Proses ini menghasilkan volume WAL yang luar biasa besar dalam waktu singkat. Server Standby, yang seringkali memiliki spesifikasi I/O disk yang lebih lambat atau sedang melayani kueri reporting yang berat, akan kewalahan “mengunyah” dan menerapkan (replay) volume WAL raksasa tersebut.
- Konflik Penerapan (Apply Conflicts) Ini adalah skenario yang paling sering luput dari perhatian. Server Standby kita tidak hanya diam; ia biasanya digunakan untuk Read-Only Queries (seperti laporan analitik yang memakan waktu berjam-jam). Jika server Primary menghapus sebuah baris data (dan mengirimkan instruksi hapus tersebut via WAL), tetapi server Standby sedang menjalankan kueri lambat yang sedang “membaca” baris data tersebut, PostgreSQL di Standby akan menunda penerapan WAL tersebut untuk mencegah pembacaan data yang rusak. Ini disebut Apply Conflict, dan akan memicu lag hingga kueri laporan tersebut selesai (atau dibatalkan paksa).
Cara Mengendalikan Lag
Bagaimana kita menjaga agar kemacetan ini tidak menjadi bencana data?
- Pantau LSN secara Real-Time: Kita wajib memantau view
pg_stat_replicationdi server Primary. Selisih antarapg_current_wal_lsn()danreplay_lsndari Standby adalah metrik paling krusial. Konversikan selisih LSN ini menjadi hitungan Byte atau detik untuk memicu sistem alerting (seperti Prometheus/Grafana) jika lag melebihi batas toleransi. - Gunakan Replication Slots: Jika lag terjadi terlalu lama, server Primary bisa saja menghapus file WAL lama yang sebenarnya masih dibutuhkan oleh Standby untuk mengejar ketertinggalan. Hal ini akan merusak replikasi secara permanen. Gunakan Replication Slots agar Primary dengan cerdas menahan file WAL di disk sampai Standby benar-benar selesai menerapkannya. (Peringatan: Pantau kapasitas disk Primary kita, karena file WAL yang ditahan bisa membuat disk penuh!).
- Aktifkan Hot Standby Feedback: Untuk mengatasi masalah Apply Conflict, kita dapat mengatur parameter
hot_standby_feedback = on. Ini membuat Standby secara berkala memberi tahu Primary transaksi mana saja yang sedang aktif dibaca, sehingga Primary tidak akan langsung membersihkan data wal yang masih dibutuhkan oleh Standby.
Kesimpulan
Replication Lag di infrastruktur Asinkronus adalah sesuatu yang normal dan pasti terjadi. Tugas kita bukanlah menghilangkannya hingga menjadi absolut nol, melainkan mendesain topologi jaringan dan arsitektur hardware agar lag tersebut selalu berada di bawah Recovery Point Objective (RPO) yang disepakati oleh bisnis.
Pastikan kita memiliki visibilitas yang baik terhadap metrik ini, karena Standby yang tertinggal berjam-jam sama tidak bergunanya dengan tidak memiliki Standby sama sekali saat bencana benar-benar melanda.
